Нейросеть для субтитров: как сделать титры к видео на русском
Субтитры к ролику собираются за минуту, без ручной расстановки таймингов.
Показываю на своих роликах: чем расшифровывать русскую речь, как получить тайминги на каждое слово и что обязательно проверять руками.

Раньше я ставил тайминги на глаз: смотрел ролик, записывал секунды, подставлял в файл.
Текст уезжал на две-три секунды, и это видел каждый зритель.
- Расшифровка на русском работает бесплатно и на своей машине, видеокарта не нужна
- Тайминги ставит нейросеть, до каждого слова
- Караоке-титры с подсветкой слова делаются из тех же таймкодов
- Вычитка обязательна: русские слова модель путает предсказуемо
- На часовое видео уходит минут пять машинного времени
Что нейросеть делает с субтитрами
Задача разбивается на три части, и все три автоматизируются.
- Расшифровать речь в текст. Тут нейросеть давно точнее ручной работы
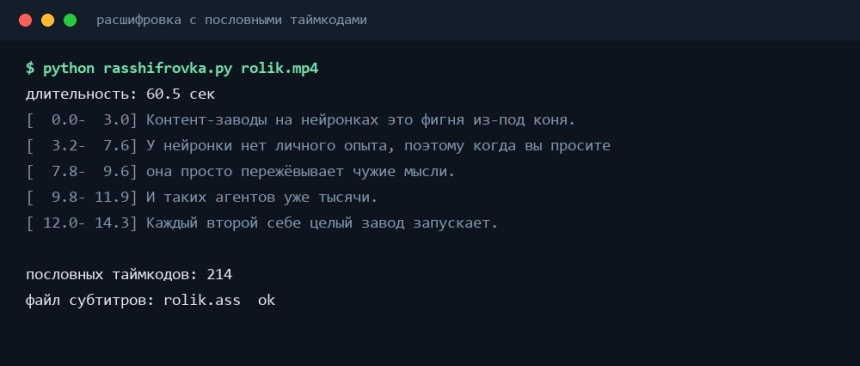
- Расставить тайминги. Каждое слово получает начало и конец с точностью до сотых
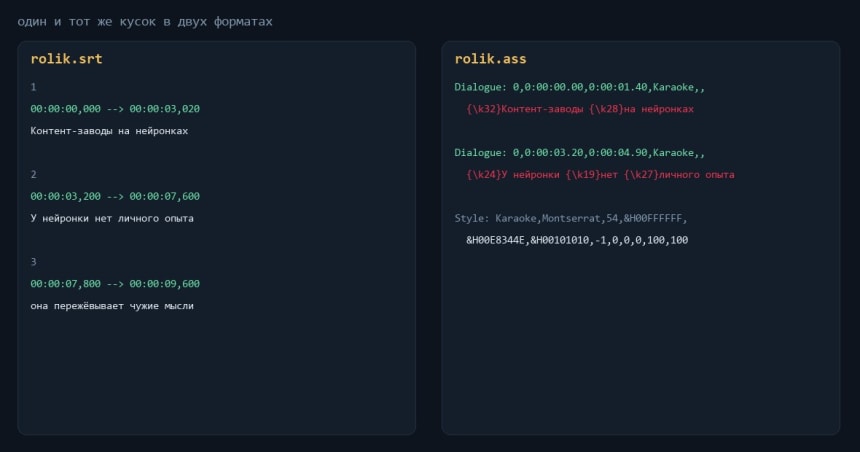
- Собрать файл титров. Из таймкодов получается SRT для ютуба или ASS для вшитых субтитров
Что остаётся человеку: вычитка и решение, как титры выглядят.
Зачем субтитры вообще нужны в цифрах
Аргумент про "звук выключен" знают все, но полезнее посмотреть на свои же цифры.
Я разобрал 14 своих роликов по статистике. Удержание было от 5 до 20 секунд, то есть люди смотрели. При этом на просмотры удержание почти не влияло: все четырнадцать собрали по 100-170 показов и остановились там.
Вывод, который я забрал: титры нужны, но охват они не поднимают. Без них ролик в ленте теряет тех, кто листает без звука. С ними он получает шанс, дальше решает содержание.
Отдельная польза, о которой забывают: расшифровка это готовый текст. Из часовой записи получается материал на несколько постов, и переписывать ничего не надо, только править. На этом же сырье потом собирается контент-план на месяц.
Веду канал с инструкциями, как привлекать клиентов из соцсетей с помощью нейросетей. Разборы с цифрами выходят там раньше, чем в блоге.
Подписаться на каналКакой нейросетью расшифровывать русскую речь
Рабочих вариантов на русском немного, и все они выросли из одной модели.
| Инструмент | Что даёт | Кому подойдёт |
|---|---|---|
| faster-whisper | расшифровка с таймкодом на каждое слово, работает на процессоре | основной вариант, ставится одной командой |
| stable-ts | выравнивает готовый текст по звуку | когда текст уже написан, а нужны точные границы |
| WhisperX | расшифровка плюс разметка говорящих | интервью на два голоса, но разметка требует видеокарты и у меня не запустилась |
| Онлайн-сервисы | расшифровка без установки | когда нужен разовый файл, но текст уходит на чужой сервер |
Я работаю на faster-whisper. Замеры ниже сняты на модели small: на обычном ноутбуке без видеокарты минута речи расшифровывается примерно за пять секунд. Модель large-v3-turbo точнее на именах и терминах, но идёт заметно дольше.
Почему тайминги должна ставить нейросеть
Это моя главная ошибка первых роликов.
Смотришь видео, записываешь, что на седьмой секунде начинается фраза, ставишь её в файл. Дальше текст плывёт: где-то на полсекунды, где-то на три.
Зритель этого не прощает. Субтитр, который приходит позже слова, выглядит как ошибка, даже если человек не понимает почему.
Правильно так: расшифровка отдаёт границы каждого слова, титры собираются из них. Тогда текст появляется ровно с голосом.
Есть отдельный случай, когда текст уже написан заранее. Например, вы озвучили готовый сценарий. Тогда достаточно выравнивания: подаёте текст и звук, получаете точные тайминги. Полный прогон тут лишний. В stable-ts это отдельный режим, и он точнее, чем расшифровывать заново.
Караоке-титры: нейросеть подсвечивает слово
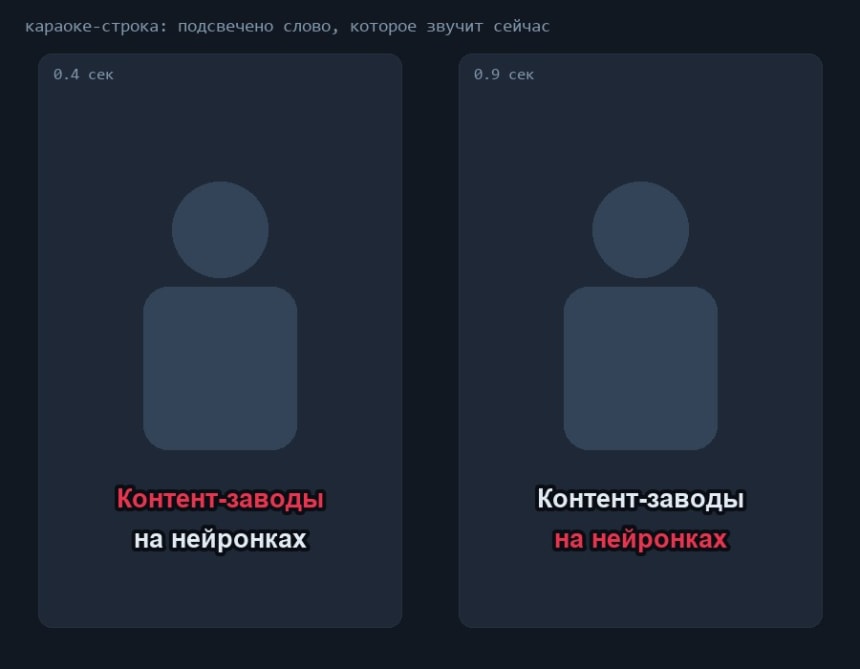
Формат, который держит внимание в вертикальных роликах: на экране два-три слова, текущее подсвечено цветом.
Собирается он из тех же пословных таймкодов. Слова группируются по два или три, каждой группе задаётся своё окно, внутри окна подсветка переходит от слова к слову.
Что я подобрал на своих роликах:
- Два слова в группе для быстрой речи, три для спокойной
- Шрифт крупный, с жирной обводкой, иначе на светлом кадре текст пропадает
- Титры внизу, но выше интерфейса приложения, иначе их перекроет кнопками
- Подсветка идёт цветом, от увеличения строка прыгает
Что нейросеть слышит неправильно
Вычитка обязательна, и это не формальность.
На русском расшифровка ошибается предсказуемо:
- "внести" превращается в "мнести"
- "в воронках" становится "баронах"
- английские названия пишутся кириллицей на слух
- имена и термины из вашей ниши модель не знает и подставляет похожее по звуку
Правило простое: прочитать расшифровку целиком перед сборкой. Если текст потом пойдёт в пост, прогоните его ещё и по признакам машинного текста. На ролике в минуту это тридцать секунд работы, на часовой записи около двадцати минут.
Отдельно про длинные видео. Модель иногда зацикливается и повторяет одну фразу несколько раз подряд. Такое место видно сразу, если пробежать текст глазами.
Весь путь от записи до готовых титров
Порядок, который у меня собран в одну команду.
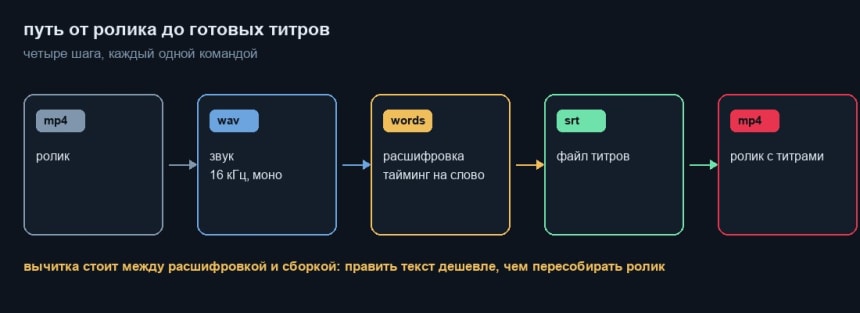
- Достаём звук из видео и переводим в моно с частотой 16 килогерц
- Прогоняем расшифровку с пословными таймкодами
- Читаем текст и правим ослышки
- Собираем файл титров: SRT для площадок, ASS для вшитых
- Накладываем титры последними в цепочке фильтров, после всех кропов и цветокора
Последний пункт важен: если наложить титры раньше, а потом кадрировать, текст обрежется вместе с кадром.
Как это собрано у меня
Всё описанное выше я свёл в одну команду, чтобы не повторять шаги руками.
На вход идёт запись разговора, на выходе получается вертикальный ролик с титрами. Внутри цепочка: расшифровка с пословными таймкодами, вырезание пауз длиннее полусекунды, зумы по границам слов, поиск лица для кадрирования, титры по два слова, музыка с приглушением под голос.
Двадцать семь секунд готового ролика собираются за тридцать одну секунду работы. Замер снят на модели small.
Что при этом важно на самой записи:
- Лицо крупно по центру, тогда вертикаль обрезается без потерь
- Паузы в секунду-две между мыслями, по ним идёт нарезка
- Оговорился, повторяешь фразу заново, не останавливая запись
- Вставку называешь голосом, "тут покажу экран", и она подставится по таймкоду
Запись беру локальным файлом. Облачная версия отдаёт 360p, после растяжки в вертикаль это мыло.
Можно ли сделать субтитры бесплатно
Да, и это основной путь. Расшифровка на своей машине не стоит ничего: модель скачивается один раз и дальше работает без интернета.
Платить есть смысл в двух случаях. Когда нужен разовый файл и не хочется ничего ставить, тогда проще открыть онлайн-сервис. И когда важна точность на именах и терминах: платные расшифровки ошибаются реже на редких словах.
Скрытая цена бесплатного варианта это время на первую настройку. У меня на неё ушёл вечер, дальше всё идёт одной командой.
Какие команды я запускаю для субтитров
Разбираю ту самую сборку по шагам. Внутри неё четыре шага. По отдельности они работают так же. Всё бесплатное, ставится один раз.
pip install faster-whisper
# ffmpeg ставится отдельно с ffmpeg.org и должен быть виден в PATH
Первое: достать звук. Привести его надо к виду, который любит расшифровка: одна дорожка, 16 килогерц, без картинки.
ffmpeg -i rolik.mp4 -vn -ac 1 -ar 16000 zvuk.wavВторое: расшифровка. Границы фраз модель отдаёт всегда, а вот word_timestamps=True добавляет к ним разбивку по словам, она приходит в поле words. Караоке-субтитры собираются именно оттуда.
from faster_whisper import WhisperModel

модель = WhisperModel("small", device="cpu", compute_type="int8")
сегменты, инфо = модель.transcribe("zvuk.wav", language="ru", word_timestamps=True)
сегменты = list(сегменты)   # иначе пройти по ним получится только раз

for сегмент in сегменты:
    for слово in (сегмент.words or []):
        print(слово.start, слово.end, слово.word)
Третье: собрать файл. Для площадок хватает SRT, он собирается из тех же таймингов коротким скриптом.
def тк(с):
    ч, о = divmod(int(с), 3600)
    м, _ = divmod(о, 60)
    return "%02d:%02d:%06.3f" % (ч, м, с % 60)

with open("rolik.srt", "w", encoding="utf-8") as ф:
    for н, с in enumerate(сегменты, 1):
        нач, кон = тк(с.start).replace(".", ","), тк(с.end).replace(".", ",")
        ф.write("%d\n%s --> %s\n%s\n\n" % (н, нач, кон, с.text.strip()))
Четвёртое: вшить титры. Тут важен порядок фильтров: кроп идёт первым, титры последними, иначе строка уедет за край вместе с кадром. Цифры в кропе считаются от исходника: из кадра 1920 на 1080 берём всю высоту и полосу шириной 608, отступив 656 слева, и растягиваем до вертикали.
ffmpeg -i rolik.mp4 -vf "crop=608:1080:656:0,scale=1080:1920,subtitles=rolik.srt" \
  -c:a copy gotovo.mp4
Вшиваю здесь SRT, потому что мы его только что собрали руками. ASS ставится в ту же команду на место subtitles и нужен, когда хочется караоке-строку. Между вторым и третьим шагом стоит вычитка. Правится текст, пока ролик ещё не собран, и это занимает меньше минуты на короткий ролик. Остальную часть сборки, от поиска кадра до нарезки под музыку, я разобрал в статье про нейросети для монтажа видео.
Как научить нейросеть именам и терминам
Отдельная головная боль на роликах про работу. Модель отлично знает обычную речь и спотыкается ровно там, где у вас профессиональные слова: названия сервисов и имена. Каждый раз править это руками утомительно, потому что ошибка повторяется из ролика в ролик одинаково.
Лечится это подсказкой. У расшифровки есть параметр initial_prompt: туда кладётся текст, который модель считает началом разговора и подстраивает под него распознавание. Работает как словарь: слова из подсказки она начинает узнавать.
подсказка = "Разговор про маркетинг. Встречаются слова: Threads, BotHelp, Тильда, воронка, прогрев, лид-магнит."

сегменты, инфо = модель.transcribe(
    "zvuk.wav", language="ru", word_timestamps=True,
    initial_prompt=подсказка)
Держите подсказку короткой. Длинная работает хуже: модель начинает тянуть слова оттуда даже туда, где их не говорили. Мне хватает одной строки с десятком слов, которые повторяются во всех роликах.
Подсказка сильнее всего влияет на начало записи: на длинном ролике модель может сбросить её на середине и дальше идти без неё. В свежих версиях faster-whisper для этого есть отдельный параметр hotwords, он так не сбрасывается.
Второй способ проще. Собрать список своих постоянных ошибок и править их автозаменой уже в готовых субтитрах. У меня в этом списке сейчас около двадцати слов, и все они из моей же ниши. Тем же способом я держу список признаков машинного текста, только там собраны ошибки стиля.
Подсказка при этом бесплатна. Взять модель побольше или уйти на платную расшифровку тоже вариант, они ошибаются на редких словах реже, но подсказка со словарём закрывает ту же задачу бесплатно.
Форматы субтитров: SRT, ASS и VTT
Три расширения, между которыми приходится выбирать. Качество текста одинаковое. Разница в том, что формат умеет держать сверх него.
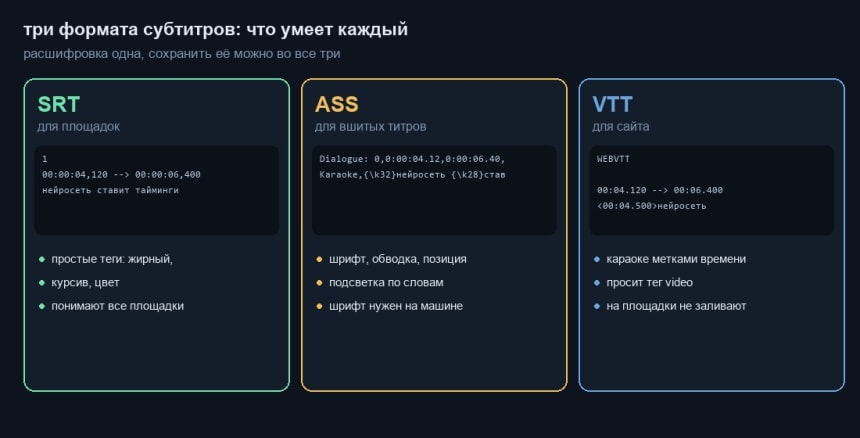
SRT это номер строки, таймкод и текст. Из оформления он тянет только простые теги вроде жирного и курсива, и то не везде одинаково. Зато его понимает всё подряд, от ютуба до плеера в телефоне. Это рабочий выбор, когда субтитры отдаются файлом.
ASS держит полное оформление: шрифт, обводку, положение на экране, подсветку по словам. Караоке-строку в SRT собрать нельзя. В ASS она собирается штатно. Шрифт при этом подставляется на той машине, где вы собираете ролик, поэтому он должен быть у вас установлен.
VTT сделан для браузера, его просит тег video в вёрстке. Караоке он тоже умеет, метками времени прямо внутри строки, так работает подсветка в автосубтитрах ютуба. На сайт субтитры кладут в нём, на площадки заливают SRT.
Практика простая. Расшифровка одна, сохранить её можно во все три, формат выбирается в момент выгрузки.
Вшивать или отдавать файлом
Два разных сценария, и путать их не стоит.
Файлом отдают на ютуб и в подкаст-платформы: площадка сама покажет титры, а поисковик прочитает текст. Это плюс к тому, что ролик находят.
Вшивают в вертикальные ролики для соцсетей: там субтитры включены у единиц, и без них звук в ленте никто не услышит.
На вшитых титрах есть подвох: изменить их потом нельзя, только пересобирать ролик. Поэтому сначала вычитка, потом сборка.
Почему субтитры ломаются на кириллице
Три вещи ломают русский текст в титрах и не трогают английский. Все три я поймал на своих роликах.
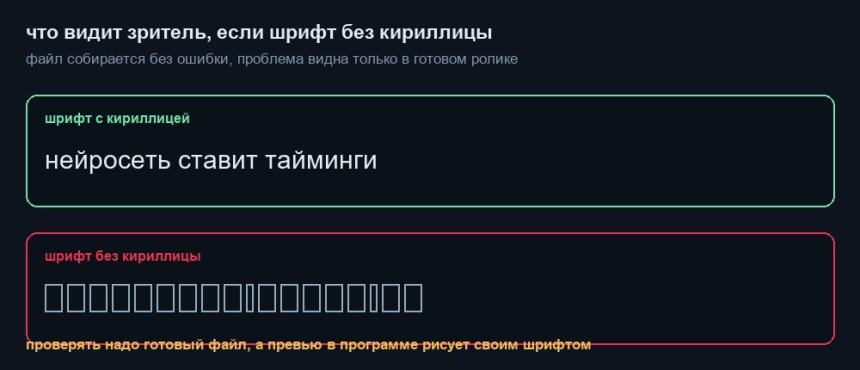
Шрифт без кириллических букв. Файл соберётся без ошибки, но вместо слов пойдут пустые прямоугольники. Так ведут себя многие красивые шрифты с бесплатных сборников: латиница в них есть, русских букв нет.
Файл титров не в UTF-8. Блокнот на Windows любит сохранять в кодировке системы, и текст приезжает крякозябрами. Кодировку надо задавать явно при сохранении, как в примере с SRT выше.
Русские буквы и двоеточия в пути к файлу. Внутри фильтра ffmpeg путь разбирается по своим правилам, и C:\Видео\rolik.srt ломает команду целиком. Лечится тем, что файл кладётся рядом с роликом и зовётся коротким именем латиницей.
Нужна ли видеокарта для субтитров
Короткий ответ: нет. Расшифровка идёт на процессоре, и это работает даже на ноутбуке со встроенной графикой.
Видеокарта нужна в двух случаях. Первый: разметка говорящих, когда надо понять, где в записи один голос, а где второй. Второй: длинные записи, где час расшифровки хочется получить за минуту вместо пяти.
У меня видеокарты нет, поэтому разметку говорящих я не использую вообще. На роликах с одним человеком в кадре она и не нужна.
Сколько времени занимает работа нейросети
Замеры на моей машине, обычный ноутбук со встроенной графикой.
- Ролик на минуту: расшифровка секунд пять, вычитка полминуты, сборка мгновенно
- Ролик на 15 минут: расшифровка около минуты, вычитка минут пять
- Часовая запись: расшифровка минут пять, вычитка минут двадцать
Дольше всего идёт чтение глазами, машина справляется быстро. Именно поэтому длинные записи я расшифровываю целиком, а титры собираю только для нарезанных кусков.
Субтитры на другом языке
Задача решается в два прохода. Сначала расшифровка на языке оригинала, потом перевод текста поверх готовых таймингов. Расшифровывать сразу в перевод не стоит, тайминги от этого плывут.
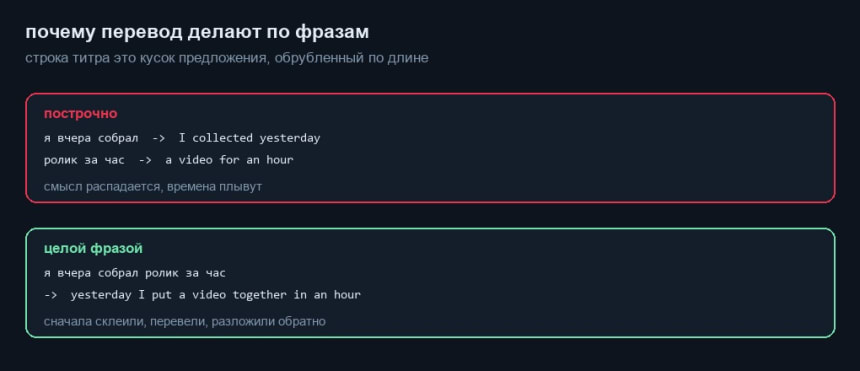
Переводить надо целыми фразами, иначе перевод выходит бессмысленным. Строка титра это кусок предложения, обрубленный по длине, и сама по себе она значит другое. Поэтому текст сначала собирается по предложениям, переводится целиком, и только потом раскладывается обратно по таймкодам.
Вычитка нужна и здесь. На переводе модель выдаёт термины, которых в языке нет, и выглядят они совершенно обычно.
Частые вопросы
Какая нейросеть делает субтитры на русском лучше всех?
Whisper и его быстрые сборки вроде faster-whisper. Русский они понимают хорошо, ошибаются предсказуемо и дают тайминги на каждое слово.
Можно сделать субтитры бесплатно?
Да. Расшифровка на своей машине бесплатна и не требует видеокарты. Платить приходится только за время на установку.
Нужна ли мощная видеокарта?
Нет. Расшифровка идёт на процессоре. Видеокарта нужна только для разметки говорящих и ускорения на длинных записях.
Как сделать субтитры с подсветкой слова?
Взять пословные таймкоды из расшифровки, сгруппировать слова по два-три и задать подсветку внутри группы. Формат ASS это умеет из коробки.
Обязательно ли вычитывать расшифровку?
Да. Модель путает похожие по звуку слова, а на длинных записях иногда повторяет фразу. Минута чтения экономит переделку ролика.
Собираете контент через нейросети?
В канале показываю на своих задачах: как ведётся сайт, как пишутся тексты и как собираются ролики, с командами и цифрами.
Разбираю там же промахи, чтобы вы не повторяли мои.
Читать каналИ загляните в справочник признаков машинного текста.
Маркетолог и продюсер экспертов.
Веду сайт, тексты и видео через агента, пишу разборы со своими цифрами.
Веду канал с инструкциями, как привлекать клиентов из соцсетей с помощью нейросетей. Разборы с цифрами выходят там раньше, чем в блоге.
Подписаться на канал