Humanizer для текста нейросети: как я правлю черновик, чтобы его читали люди
Сразу про то, чего здесь нет. Сервиса, который перепишет текст так, чтобы его не узнал детектор в вузе или антиплагиат, тут не будет, и учить такому я не стану. Статья для эксперта, у которого нейросеть сделала черновик поста, а читать его будут живые люди. Они такие тексты уже узнают. В чате экспертов это написали одной фразой. "Клод и в дизайне плох тоже, этот AI-slop сразу видно, какие бы там не были скилы подключены".

Ниже один пост нейросети и пять шагов правки с проверкой на 245 признаков. До правки проверка нашла 5 признаков машинного текста, после правки ноль.
Если коротко
Humanizer это набор правил, по которым из текста убирают приметы нейросети. Его ставят в Claude как скилл или держат списком и правят руками. Большинство таких правил ловит слова вроде длинного тире или оборота "не просто".
На свежих моделях этого мало, и я это проверил. Убрал из черновика все такие слова, длинных тире стало ноль вместо восьми. А признаков формы как было 5, так и осталось 5. Текст выдаёт форма. Двоеточие посреди фраз, буква ё во всех словах подряд, ни одного дефиса с пробелами, ни одной скобки и ни одного восклицательного знака на 300 слов.
Поэтому правка идёт в пять шагов.
- Проверка и разбор находок на стиль и форму.
- Убрать то, что нейросеть придумала, то есть цифры и отзывы, которых не было.
- Заменить её слова словами читателя.
- Вычистить конструкции, которые скрипт не считает.
- Форма и проверка ещё раз.
Пост психолога после этих шагов ужался с 315 слов до 164. Разбираю по порядку на этом посте.
Humanizer для своего текста и сервис обхода детектора
По слову humanizer в Яндексе 1 877 запросов в месяц. Под ним сидят два разных желания. Одни ищут "skill humanizer" и "claude humanizer skill", то есть инструкцию, после которой нейросеть пишет без машинных привычек. Другие ищут "undetectable ai humanizer" и "humanizer detector". Им нужен сервис, который перепишет текст так, чтобы программа-детектор не узнала нейросеть.
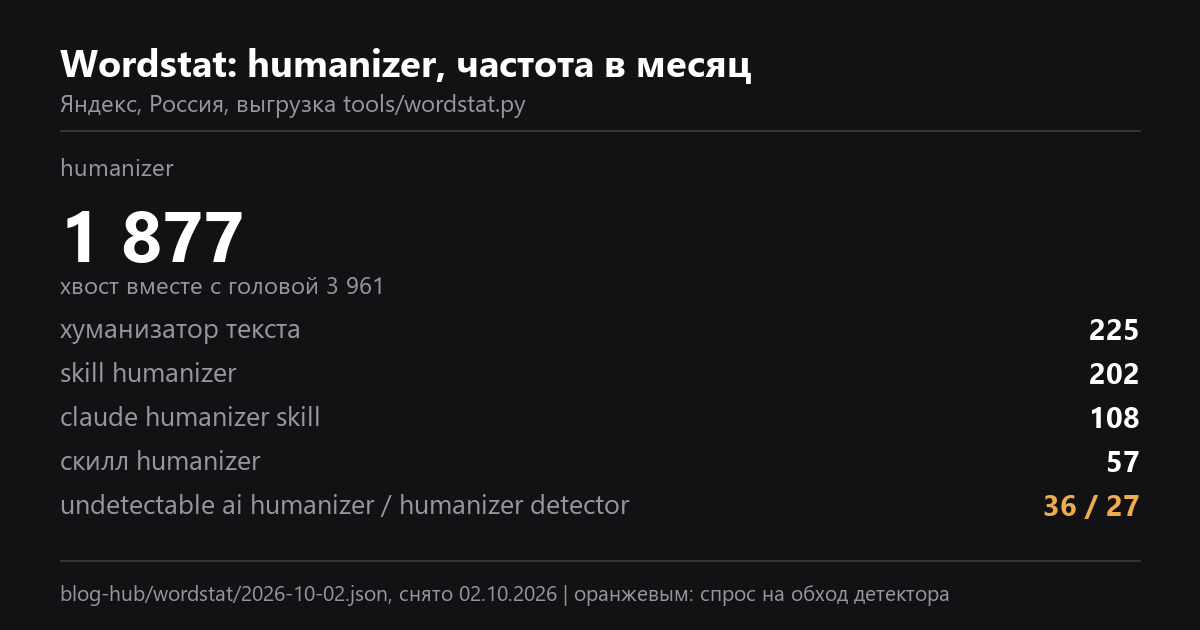
Вторым я не занимаюсь. Если вы учитесь и хотите сдать сгенерированную работу как свою, это нарушение правил учебного заведения, и статья тут не поможет. Детекторы я не проверял и обещать "пройдёт" не буду.
Первое нужно мне каждый день. Свои тексты я пишу сам, нейросеть помогает с черновой работой и проверкой. А у читателей к нейросетям своё отношение. Вот как это звучит в комментариях у коллеги. "Я пока нейронки вообще не использую. Они меня как-будто больше тормозят, чем ускоряют". Человек с таким опытом закроет пост на втором абзаце, если узнает в нём нейросеть, и дело будет уже не в теме поста.
На GitHub лежат готовые скиллы humanizer для Claude, есть и русские. Это списки запретов на несколько десятков пунктов. Вещь полезная, но у неё есть потолок, и на примере ниже он хорошо виден.
Веду канал с инструкциями, как привлекать клиентов из соцсетей с помощью нейросетей. Разборы с цифрами выходят там раньше, чем в блоге.
Подписаться на каналОткуда 245 признаков, если в справочнике 205
На сайте лежит справочник маркеров нейротекста. В нём 205 признаков в 27 группах, к каждому правка. По нему удобно читать свой текст глазами, и он никуда не делся.
25 сентября я пересчитал этот список на своих текстах. 25 признаков добавил из сравнения, что часто встречается в текстах нейросети и почти не встречается в моих. Ещё 16 пришли из внешнего обзора. Их я проверил на своих переписках и постах 2024-2025 годов, у меня они встречаются от нуля до половины раза на тысячу текстов. Один пункт убрал. Это "мне кажется", так постоянно пишут живые люди, и уликой оно быть не может. Итого 205 + 25 + 16 - 1 = 245.
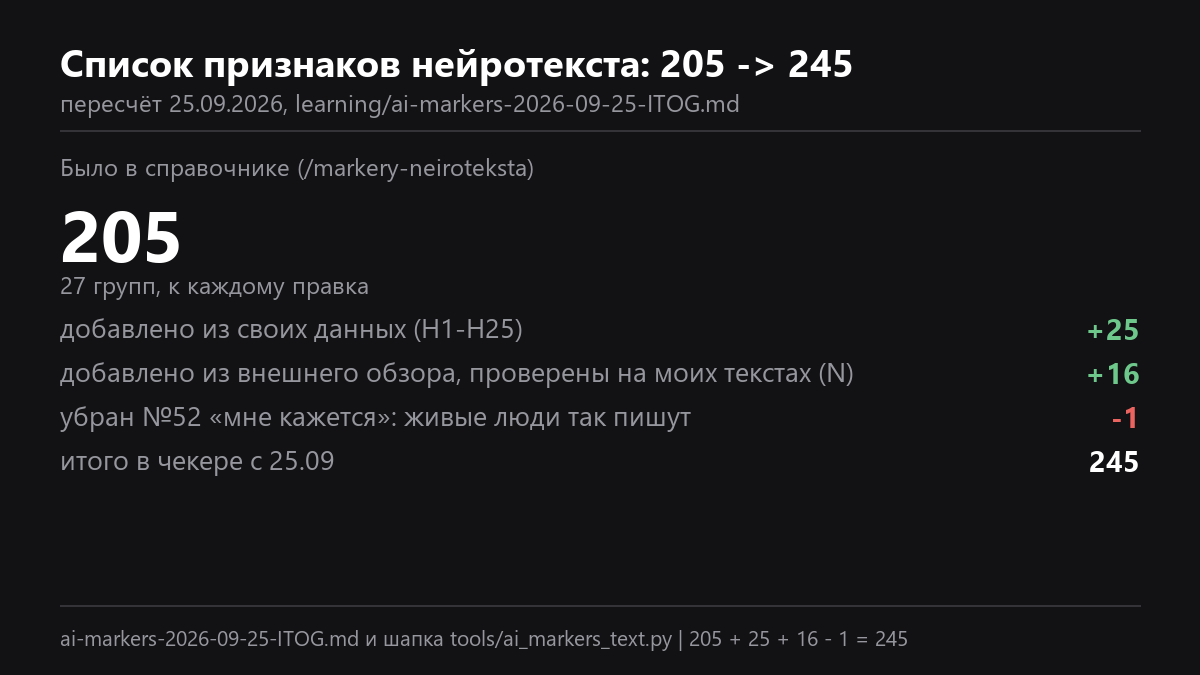
Главное, что показал пересчёт. Свежие модели почти перестали писать заезженные слова, и словарь их не ловит. Их выдаёт форма. Глазами её видно плохо, поэтому форму считает скрипт.
Скрипт у меня свой, на Python. Находки он делит на две кучи. В первой стиль, это мои личные запреты вроде длинного тире. Во второй признаки ИИ, то есть форма, по которой нейросеть отличается от живого автора. Если признаков формы 4 и больше, пост уходит на переписку.
Черновик нейросети, на котором проверю humanizer
Свой текст для примера я брать не стал. Дал нейросети запрос, какой обычно пишет эксперт, без правил стиля и без примеров.
"Напиши пост для моего Telegram-канала. Я психолог, веду канал полгода. Тема: почему подписчики читают посты, но не записываются на консультацию. Объём 1500-2000 знаков."
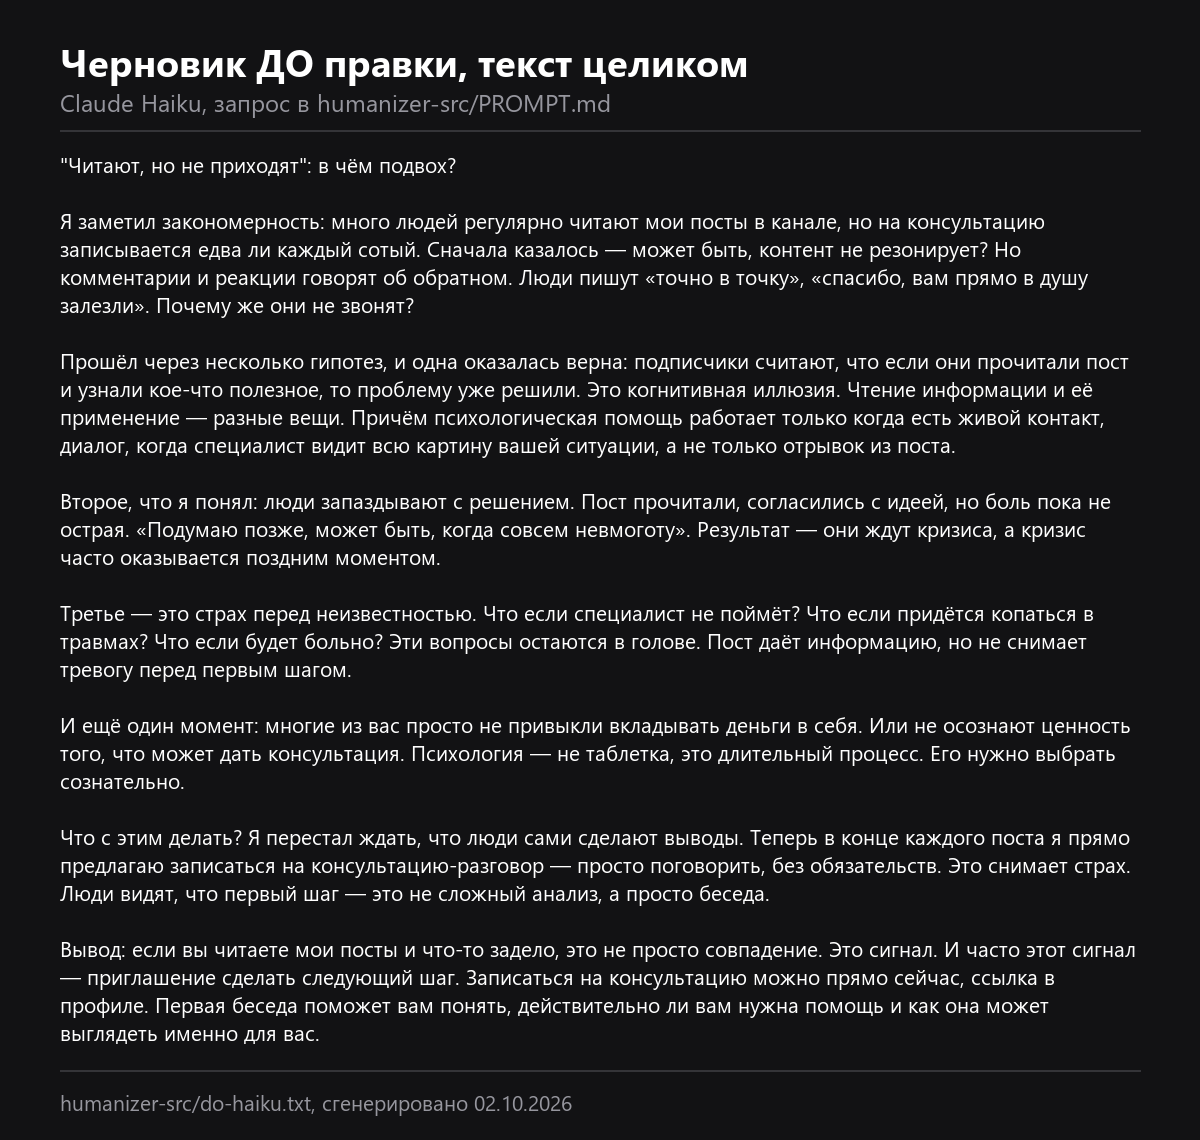
Модель Claude Haiku выдала пост на 315 слов (целиком он на карточке). Первая фраза начинается с "Я заметил закономерность" и через двоеточие объясняет, что на консультацию записывается "едва ли каждый сотый". Дальше абзацы с причинами по порядку. В конце блок "Что с этим делать?" и финал, который начинается со слова "Вывод".
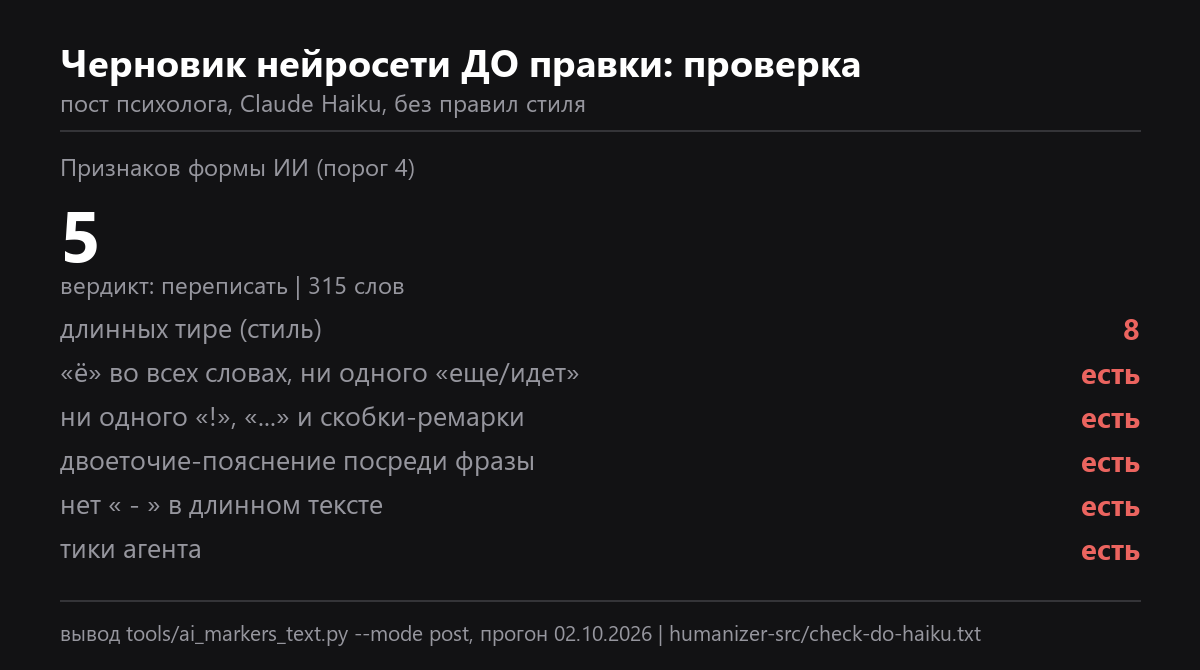
Проверка дала 5 признаков формы при пороге 4. Буква ё во всех словах, где она возможна. На 310 слов ни одного восклицательного знака, многоточия или скобки. 5 двоеточий посреди фразы. Ни одного дефиса с пробелами, которым живые люди заменяют тире. Плюс оценочное словечко из придуманного отзыва. В стиле 8 длинных тире. Вердикт чекера "переписать".
Шаг 1. Прогнать проверку и разделить находки
Первое, что делает почти любой humanizer, это правит слова. Я сделал так же и посмотрел, что получится. Убрал все длинные тире, слово "Вывод", оборот "не просто совпадение" и пару про анализ и беседу. Остальное оставил как было.
Результат на карточке. Стилевых находок ноль, тире ноль. А признаков формы как было 5, так и осталось 5, вердикт тот же. Текст стал аккуратнее и при этом читается так же, как читался.
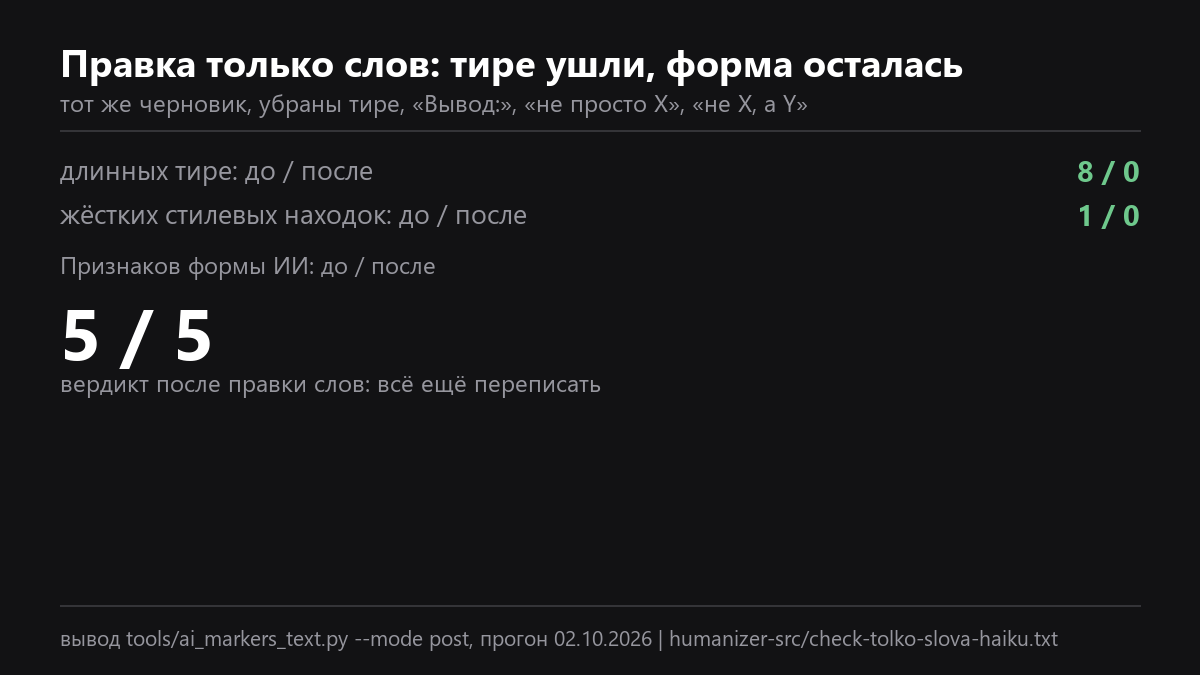
Отсюда первое правило. Находки делить на две кучи и смотреть, где их больше. Стиль правится за пять минут поиском и заменой, и именно на нём большинство людей останавливается. Форма требует переписать фразы. Если не хочется разбираться в скриптах, хватит вопроса к себе по каждому абзацу. Есть ли тут хоть одна фраза, которую я сказал бы вслух голосом? Если нет, абзац на переписку.
Вторая куча шире, чем кажется. Кроме формы, которую считает скрипт, в черновике сидят конструкции, которые видно только глазами. Их разберу в шаге 4.
Шаг 2. Выбросить то, что нейросеть придумала
Этот шаг humanizer-скиллы не делают совсем, им всё равно, правда ли написано. А читатель ловит выдумку быстрее, чем тире.
В черновике психолога две выдумки. Цифра "едва ли каждый сотый", которую психолог не называла и которой не было в запросе. И отзывы подписчиков в кавычках, которых никто не писал. Я проверил одну из этих фраз по переписке экспертов, точных вхождений ноль.
Что делать. Каждую цифру и цитату в черновике сверить со своими данными. Есть своя цифра, ставите её. Нет цифры, убираете фразу целиком. Поэтому в моей версии стоит "записались единицы". Точного числа у меня нет, а у вас оно будет своё.
Если хотите посмотреть, как я разбираю такие тексты на живых постах, заходите в канал. Там проверки и правки идут по мере того, как появляются.
Шаг 3. Заменить слова нейросети словами читателя
Нейросеть пишет словами, которыми люди о себе не говорят. В черновике было "это когнитивная иллюзия" и "контент не резонирует". Я проверил их по переписке экспертов из 10 источников. "Когнитивная иллюзия" ноль раз. "Не резонирует" 2 раза, и оба в архивном чате, где свежих сообщений 6%.
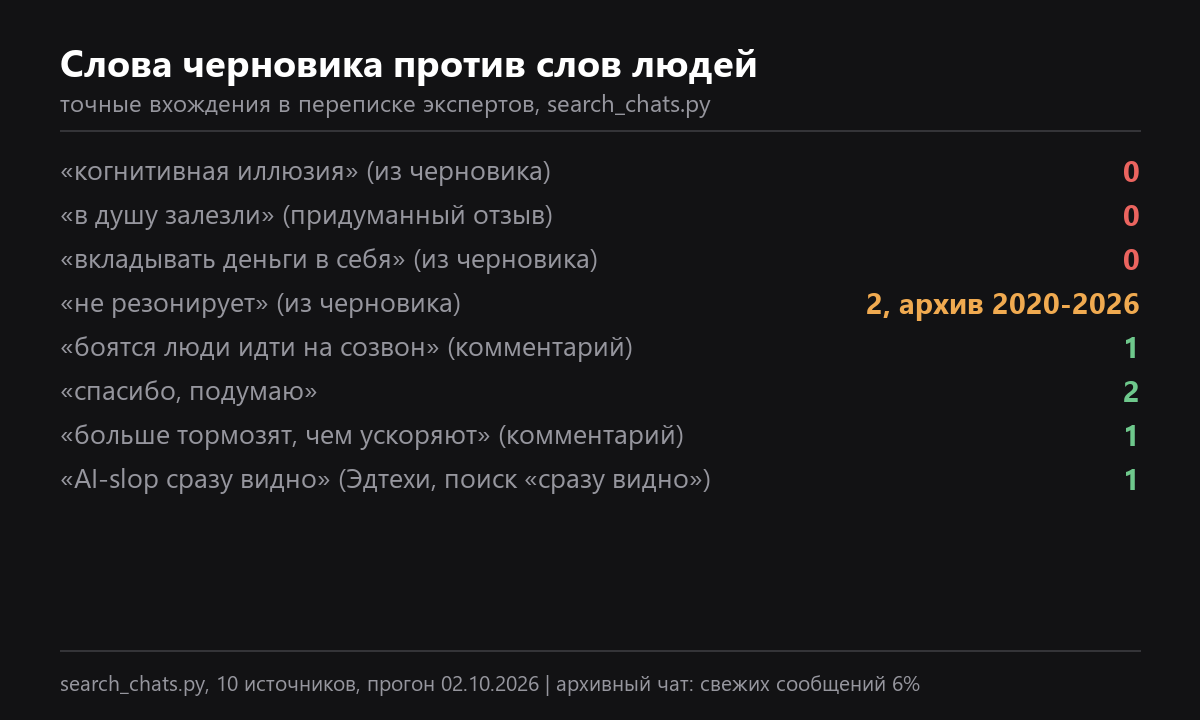
Я это знаю по себе. Когда-то ставил в посты фразу "заявки капают". Проверил по той же переписке и нашёл одно вхождение, цитату из моего же поста. Живой человек так не написал ни разу.
Чем заменить. В переписке нашлась фраза человека из комментариев. "боятся люди идти на созвон ради каких-то небольших вопросов, ибо думают, что им будут что-то втюхивать". Она объясняет ту же причину, что и "когнитивная иллюзия", только словами человека, который сам так думал. Я поставил её в пост целиком, с "ибо" и без правки.
Как сделать без моей базы. Откройте комментарии и личку за последние два месяца. Выпишите, какими словами люди описывают свою ситуацию перед тем, как написать вам или перестать отвечать. Дословно, с ошибками. Как превратить такие фразы в посты, разобрал в статье про нейросеть для постов.
Шаг 4. Вычистить конструкции, которые скрипт не считает
Скрипт считает форму, а часть признаков он не видит. Их я ищу глазами по справочнику. В черновике психолога таких находок 8.
Контрастная пара про совпадение и сигнал. Слово "Вывод" в начале последнего абзаца и мораль после него. Вопрос "Что с этим делать?" и сразу ответ на него. "Что если" три раза подряд. Две контрастные пары про таблетку и про беседу. Плюс две выдумки из шага 2, их я тоже считаю.
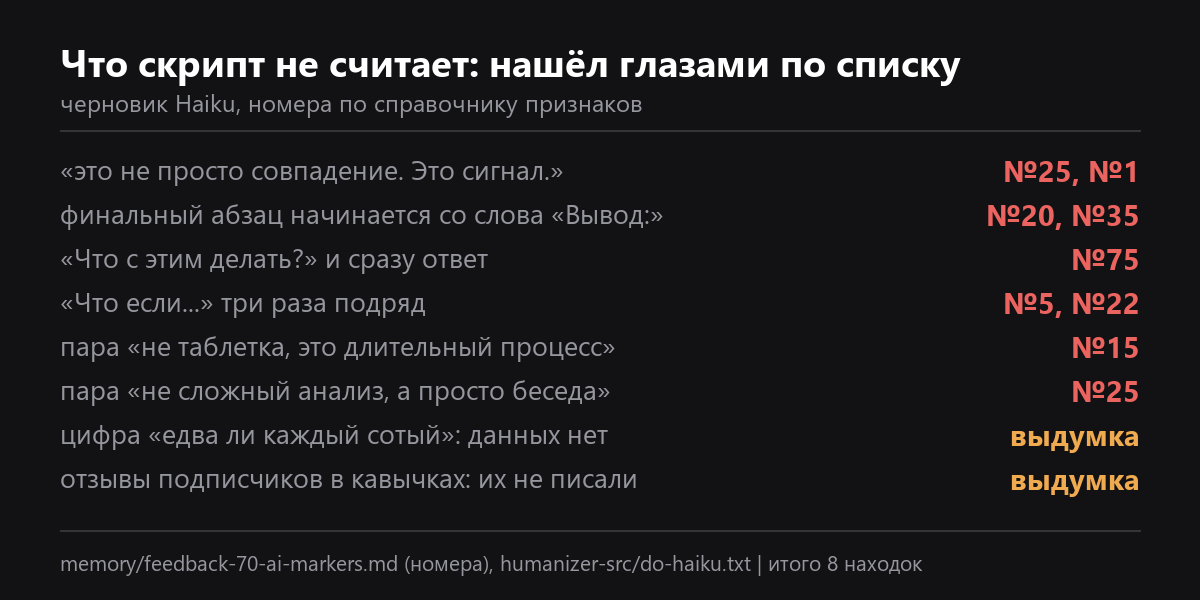
Что делаю с каждой. Контрастную пару убираю и оставляю одну мысль без разгона. Вывод выбрасываю целиком, последний абзац заканчиваю действием. Вопрос с ответом превращаю в утверждение. Из трёх "что если" оставляю одно, самое конкретное, или ни одного.
Зачем тут глаза, если есть скрипт. Эти конструкции легко сломать в другую сторону. Скрипт поймает оборот "не просто" внутри одной фразы, а ту же пару, разбитую на два предложения, пропустит. Так и вышло с совпадением и сигналом в этом черновике. Человек с перечнем рядом видит обе. Справочник для этого и сделан, с номерами и правкой к каждому пункту.
Шаг 5. Форма, которую считает скрипт
Последний шаг самый механический. Двоеточия посреди фраз меняю на точку и делю фразу на две. Длинные предложения, где по 4 запятые, режу. Одну скобку ставлю там, где она по смыслу просится как ремарка, например "человек пропадает на полгода (бывает, что навсегда)". Одно место с паузой отдаю дефису с пробелами.
Чего не делаю. Не вставляю опечатки и не пишу "еще" вместо "ещё" ради счёта. Такая правка делает текст смешным, а цель была другая. Если после трёх первых шагов признаков формы осталось 1-2, это нормально, мой порог переписки 4.
Потом проверка ещё раз. Пост психолога после пяти шагов чистый, ноль признаков формы и ноль стилевых находок. Слов 164 вместо 315.
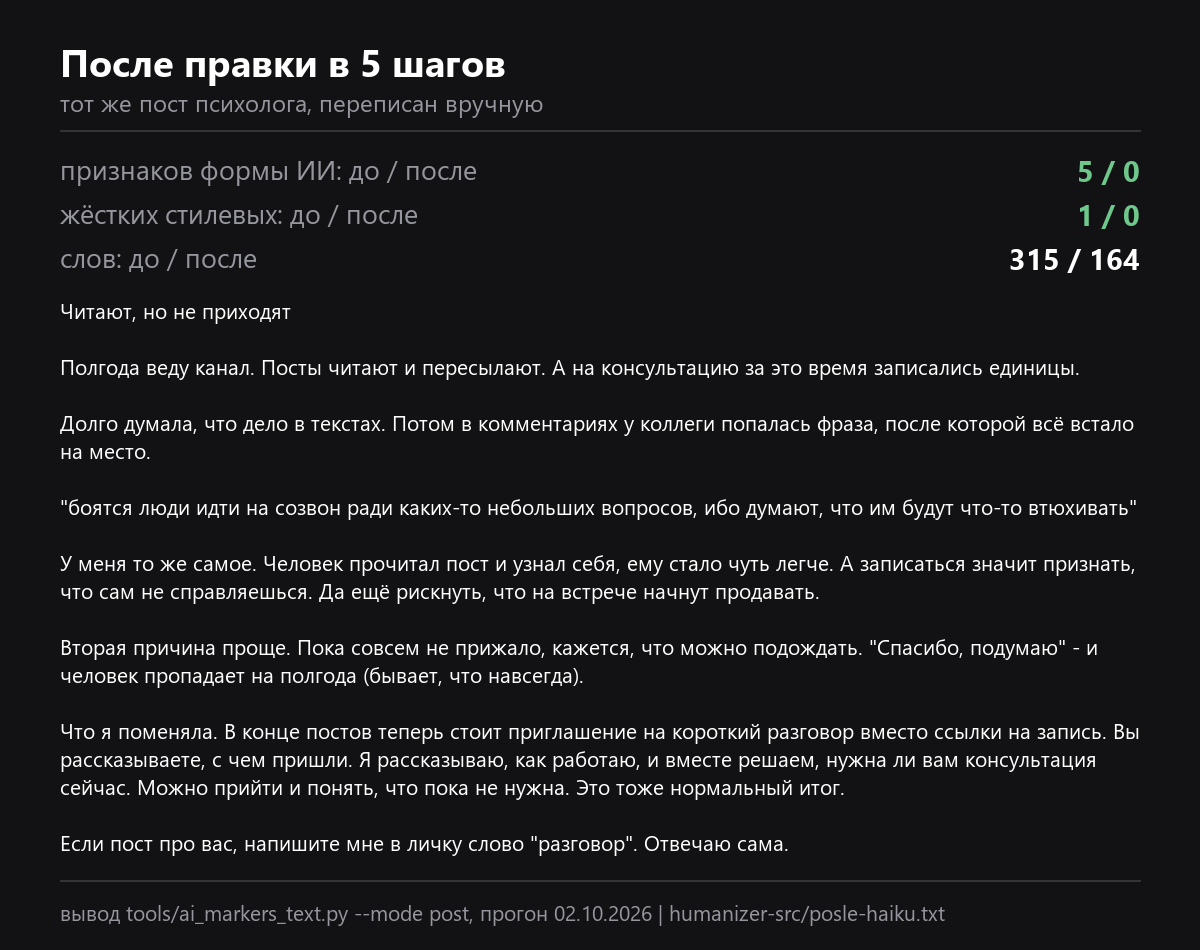
Пост после правки целиком
Читают, но не приходят
Полгода веду канал. Посты читают и пересылают. А на консультацию за это время записались единицы.
Долго думала, что дело в текстах. Потом в комментариях у коллеги попалась фраза, после которой всё встало на место.
"боятся люди идти на созвон ради каких-то небольших вопросов, ибо думают, что им будут что-то втюхивать"
У меня то же самое. Человек прочитал пост и узнал себя, ему стало чуть легче. А записаться значит признать, что сам не справляешься. Да ещё рискнуть, что на встрече начнут продавать.
Вторая причина проще. Пока совсем не прижало, кажется, что можно подождать. "Спасибо, подумаю" - и человек пропадает на полгода (бывает, что навсегда).
Что я поменяла. В конце постов теперь стоит приглашение на короткий разговор вместо ссылки на запись. Вы рассказываете, с чем пришли. Я рассказываю, как работаю, и вместе решаем, нужна ли вам консультация сейчас. Можно прийти и понять, что пока не нужна. Это тоже нормальный итог.
Если пост про вас, напишите мне в личку слово "разговор". Отвечаю сама.
Из четырёх причин черновика осталось две, и это нормально. Остальные держались на выдумках и общих словах. Конец поста зовёт на разговор, это было и у нейросети, я только убрал "прямо сейчас" и ссылку в профиле.
Почему humanizer на словах пропускает текст без тире
Тот же запрос я отдал второй модели, Claude Sonnet. Её пост вышел аккуратнее. Ни одного длинного тире, ни одной находки по моим запретам стиля. Любой humanizer на словах пропустил бы его дальше.
Проверка формы дала 4 признака при пороге 4. Буква ё во всех словах. Ни одной скобки и ни одного восклицания. 7 двоеточий посреди фраз. Запятых 0,13 на слово при пороге 0,12. Вердикт тот же, переписать.
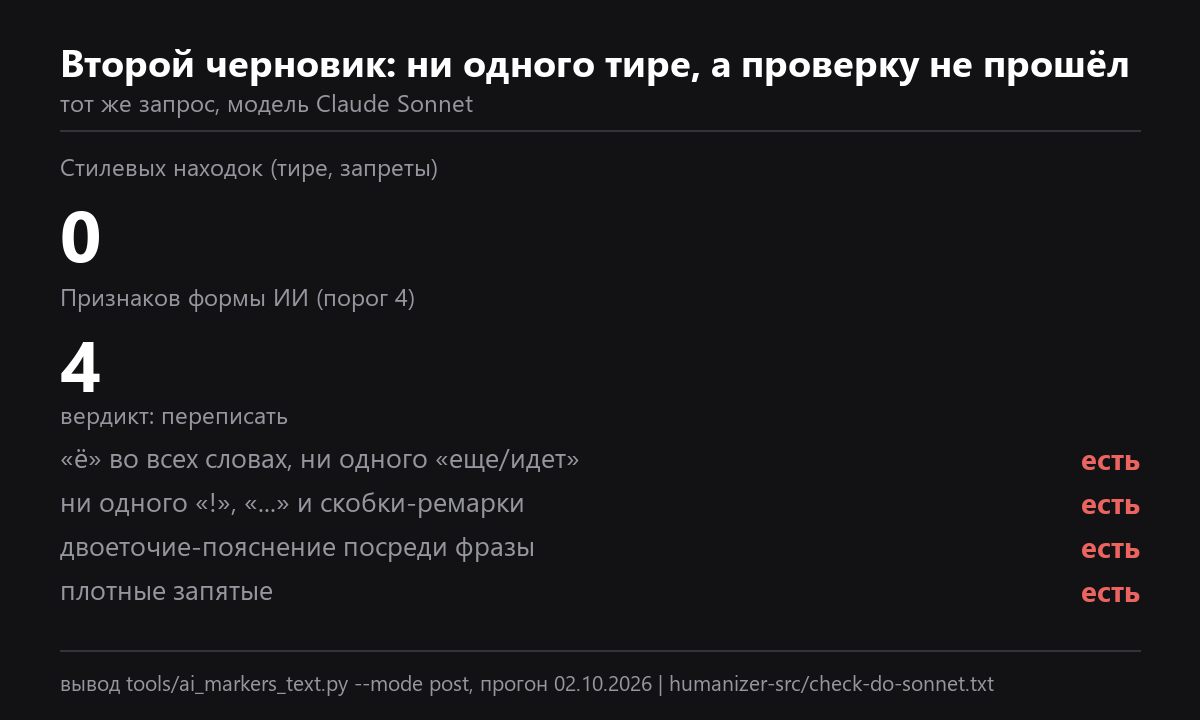
Получается, текст может пройти любую проверку на слова и всё равно читаться как нейросеть. Поэтому в моей проверке слова идут отдельной кучей и в вердикт не входят. Решает форма.
Как поставить себе humanizer в Claude
Вариант для тех, кто работает в Claude Code. Скилл это папка с файлом SKILL.md в .claude/skills/. Создайте .claude/skills/humanizer-ekspert/SKILL.md с таким текстом.
---
name: humanizer-ekspert
description: Правка черновика поста эксперта перед публикацией. Срабатывает на "проверь текст", "очеловечь", "humanizer".
---
Правишь черновик в 5 шагов и после каждого показываешь, что изменил.
1. Найди каждую цифру и цитату. Спроси автора, откуда они. Нет источника - удали фразу.
2. Найди слова, которыми люди о себе не говорят. Замени словами из комментариев автора, если он их дал.
3. Убери контрастные пары, вывод в конце, вопрос с ответом сразу за ним, повтор одного начала фразы.
4. Двоеточие посреди фразы замени точкой. Фразы длиннее 25 слов дели на две.
5. Не добавляй опечатки и сленг. Не обещай, что текст пройдёт детектор.
Если работаете в обычном чате, тот же текст без первых четырёх строк кладётся в инструкции проекта. Как писать такие инструкции, чтобы нейросеть их держала, есть в статье как писать промты.
Форму скилл не посчитает, поэтому вот мини-проверка на Python. Сохраните её как forma.py и запустите python forma.py post.txt, где post.txt это ваш черновик в кодировке UTF-8.
import re, sys

t = open(sys.argv[1], encoding="utf-8").read()
low = t.lower()
words = re.findall(r"[а-яёa-z]+", low)
n = len(words)
flags = []

YO = "ещё|её|своё|моё|идёт|пришёл|нашёл|ушёл|берёт|даёт|живёт|ждёт|счёт|отчёт|всё-таки|лёгк\\w*|жёстк\\w*"
yo = len(re.findall(r"(?<![а-яё])(" + YO + r")(?![а-яё])", low))
e = len(re.findall(r"(?<![а-яё])(" + YO.replace("ё", "е") + r")(?![а-яё])", low))
if yo >= 2 and e == 0:
    flags.append("ё во всех словах")
if n >= 25 and not re.search(r"!|\.\.\.|…|\(", t):
    flags.append("ни одного «!», «...» и скобки")
colons = len(re.findall(r"[а-яё0-9»)] ?: [а-яё0-9«]", low))
if colons >= max(2, round(2 * n / 300)):
    flags.append(f"двоеточие посреди фразы {colons}")
if n and t.count(",") / n >= 0.12:
    flags.append(f"запятых на слово {t.count(',') / n:.2f}")
if n >= 120 and " - " not in t:
    flags.append("нет дефиса с пробелами")

print("слов", n)
for f in flags:
    print("-", f)
print("признаков формы", len(flags), "из 5, от 4 переписать")
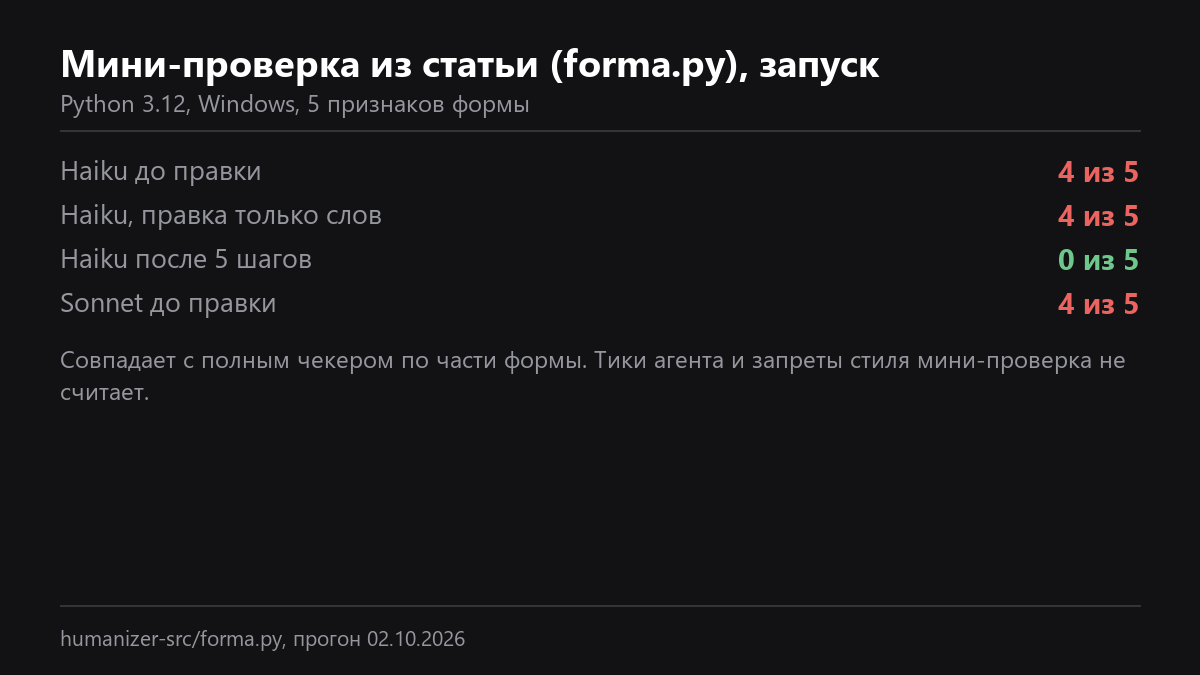
Я запустил её на всех четырёх версиях поста. Черновик Haiku 4 из 5, правка только слов 4 из 5, после пяти шагов 0, черновик Sonnet 4 из 5. С полной проверкой это совпадает по части формы. Запретов стиля и тиков мини-проверка не считает, это остаётся на справочник.
Ошибки, из-за которых humanizer делает текст хуже
Опечатки и сленг ради живости. Самая частая. По тексту с вставным "блин" через абзац всё равно видно, что писал ИИ. Живость дают свои цифры и слова читателя, опечатки тут ни при чём.
Перефразер вместо правки. Сервисы, которые переставляют слова, меняют форму, а выдумки оставляют на месте. "Каждый сотый" после перефразера останется "каждым сотым", просто другими словами.
Доверие скиллу целиком. Скилл не знает, правда ли написано. Шаг 2 делает только автор, потому что только автор знает свои цифры.
Счёт в ноль любой ценой. Если ради нуля пришлось выкинуть мысль, лучше оставить 2 признака и мысль. Мой порог переписки 4, а цель 3 и меньше, ноль бывает сам.
Сколько времени на это уходит и где нейросеть реально экономит часы эксперта, разобрал в отдельной статье нейросети и время эксперта.
Что сделать сегодня
Возьмите последний черновик, который вам сделала нейросеть. Выпишите из него все цифры и цитаты, рядом с каждой поставьте источник. Где источника нет, вычеркните. Потом откройте комментарии за месяц и найдите одну фразу читателя, которая говорит то же, что ваш самый гладкий абзац. Поставьте её вместо абзаца.
Как это выглядит на живых постах и что получается после правки, показываю в канале.

Наставник по привлечению клиентов через Telegram. 8 лет в маркетинге и продюсировании, провёл 60+ разборов экспертов. Автор метода Потока. Живу на Пхукете, разборы провожу онлайн.
